In diesem Artikel
Kurz und knapp
- Behandelte ModelleFigure 03
- Behandelte Modelle mit EU-Händler0 von 1
- Zahl der Quellen5
- Lesezeit5 Min.
- Stand2. Oktober 2026
Von der Teleoperation zu Modellen, die einen Befehl „verstehen“
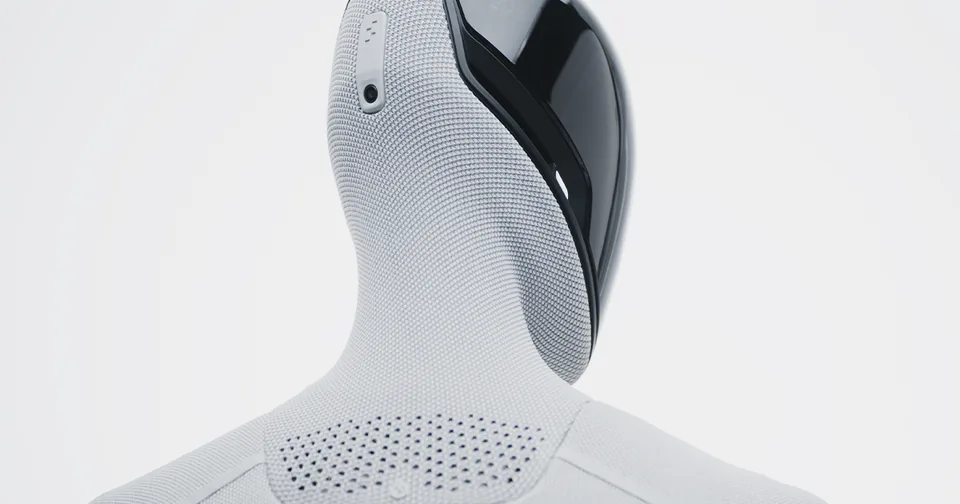
Bis vor Kurzem musste eine bestimmte Aufgabe, die ein humanoider Roboter ausführen sollte, von Hand programmiert oder von einem Bediener per Teleoperation vorgeführt werden. Der Durchbruch der letzten Jahre sind Vision-Language-Action-Modelle (VLA) – KI-Systeme, die Kamerabilder des Roboters und einen Befehl in natürlicher Sprache („Nimm die rote Tasse und stell sie ins Regal“) entgegennehmen und direkt eine Folge von Bewegungen zurückgeben. Ihnen ist es zu verdanken, dass ein Roboter wie der Figure 03 einen Gegenstand greifen kann, den er noch nie gesehen hat, ohne dass dieser Griff eigens programmiert wird. Wie sich das in die übrige Architektur des Roboters einfügt – Sensoren, Aktoren und Bordcomputer –, beschreiben wir in “Wie funktioniert ein humanoider Roboter”.
Wie ein typisches VLA-Modell funktioniert
Die meisten heutigen VLA-Modelle beruhen auf einer zweischichtigen Architektur, die einen grundlegenden Zielkonflikt löst: Modelle, die Sprache und Bilder verstehen, sind groß und langsam, die Bewegungssteuerung muss dagegen schnell sein.
Gut sichtbar ist das bei Figure Helix, entwickelt von Figure AI und im Februar 2025 beschrieben: „System 2“ ist ein Vision-Language-Modell mit 7 Milliarden Parametern, das mit 7–9 Hz arbeitet, die Szene und den Befehl analysiert und in einen internen semantischen Vektor übersetzt. „System 1“ ist ein deutlich kleineres Transformer-Modell mit 80 Millionen Parametern, das mit 200 Hz arbeitet und aus diesem Vektor in Echtzeit kontinuierliche Steuersignale für die gesamte obere Körperhälfte erzeugt – 35 Freiheitsgrade, einschließlich einzelner Finger, Handgelenk, Rumpf und Kopf. Beide Systeme werden gemeinsam Ende-zu-Ende trainiert, und Figure gibt an, dass das Modell dieses Verhalten aus rund 500 Stunden teleoperierter Vorführungen gelernt hat; eine unabhängig überprüfte Erfolgsquote bei Aufgaben veröffentlicht das Unternehmen über seine eigenen Materialien hinaus nicht.
Die wichtigsten Akteure auf dem VLA-Markt 2026
NVIDIA Isaac GR00T. Laut NVIDIA eine offene Referenzplattform für humanoide Roboter, die offene Daten, Datenverarbeitungs-Pipelines und ein trainiertes Basismodell verbindet, das Bilder und Sprache aufnimmt und Aktionen zurückgibt. Trainiert wird es mit realen Daten, synthetischen Daten und Videomaterial im Internetmaßstab, aufgebaut rund um die Simulatoren NVIDIA Omniverse und Cosmos sowie die Bibliothek CUDA-X, mit Jetson Thor als Zielhardware für die Inferenz in Echtzeit. GR00T kann Manipulationsaufgaben ausführen – Greifen, Tragen von Gegenständen mit einer oder zwei Händen, Übergeben eines Gegenstands von einer Hand in die andere – sowie mehrstufige Aufgaben in Anwendungen wie Materialtransport, Verpacken und Inspektion. NVIDIA bezeichnet GR00T als offene Plattform; in welchem Umfang Code und Gewichte der einzelnen Versionen verfügbar sind, muss im Repository von NVIDIA geprüft werden.
Google DeepMind Gemini Robotics. Laut DeepMind umfasst die Familie drei Varianten: Gemini Robotics 2 (ein vollständiges VLA-Modell mit Ganzkörpersteuerung des Humanoiden und einer Geschicklichkeit, die zum Beispiel das Knüpfen eines Knotens erlaubt), Gemini Robotics-ER 2 (spezialisiert auf räumliches Schlussfolgern und mehrstufige Planung) und Gemini Robotics On-Device 2 (eine schlanke Version, die lokal auf der Hardware des Roboters läuft, ohne Cloud-Verbindung). DeepMind sucht über eine Warteliste mehr als 100 vertrauenswürdige Tester, und zu den genannten Forschungspartnern zählen Agile Robots, Apptronik und Boston Dynamics – das Modell steht also noch nicht jedem Integrator offen zur Verfügung.
Physical Intelligence – pi0 / pi0.5. Das Unternehmen Physical Intelligence entwickelt die Familie generalistischer VLA-Modelle pi0 und pi0.5. Architektur, Umfang des veröffentlichten Codes und Testergebnisse sind in den Originalpublikationen des Unternehmens beschrieben; lesen Sie diese direkt, bevor Sie Zahlen zitieren.
Offene und akademische Modelle. OpenVLA ist ein offenes Modell mit 7 Milliarden Parametern, trainiert auf 970.000 Roboter-Episoden aus dem Datensatz Open X-Embodiment, das die Bild-Encoder SigLIP und DinoV2 mit dem Sprachmodell Llama 2 7B kombiniert. Laut seinen Autoren übertrifft es in den meisten Tests zur Steuerung mehrerer Roboter das geschlossene RT-2-X (55 Milliarden Parameter), RT-2-X schneidet jedoch bei schwierigen Aufgaben zur semantischen Verallgemeinerung besser ab, die Wissen aus dem Internet erfordern. Das Projekt AgiBot World stellt einen Datensatz bereit (Beta-Version: 1.003.672 Trajektorien, laut Repository etwa 43,8T) sowie das Modell GO-1; das Modell wurde am 19. September 2025 als Open Source veröffentlicht.
Was diese Modelle bereits können
- Greifen bisher unbekannter Gegenstände allein auf einen sprachlichen Befehl hin, ohne gesondertes Training mit genau diesem Objekt – eine der Vorzeigefähigkeiten, die sowohl GR00T als auch Helix demonstriert haben.
- Zusammenarbeit zweier Roboter an einer Aufgabe anhand von Befehlen in natürlicher Sprache – von Figure mit Helix vorgeführt.
- Ein Satz Modellgewichte für viele Aufgaben, ohne für jede neue Aufgabe gesondert nachtrainieren zu müssen – die Richtung, in die sich die gesamte Branche bewegt, weg vom früheren Ansatz „eine Aufgabe = ein trainiertes Modell“.
- Räumliches Schlussfolgern und mehrstufige Planung – laut DeepMind die Aufgabe der Variante Gemini Robotics-ER 2.
Was diese Modelle noch nicht können
Keines der öffentlich zugänglichen Materialien der Hersteller nennt eine unabhängig überprüfte Erfolgsquote bei Aufgaben unter Produktionsbedingungen jenseits kontrollierter Vorführungen – was an sich schon zeigt, dass sich die Branche in ausgewählten Anwendungen noch im Stadium des Machbarkeitsnachweises befindet und nicht in allgemeiner Einsatzreife. Zu den offen ungelösten Problemen, die in der Fachliteratur am häufigsten genannt werden, gehören:
- Verallgemeinerung über die Verteilung der Trainingsdaten hinaus – ein Modell, das mit typischen Haushalts- oder Lagergegenständen trainiert wurde, kann bei ungewöhnlichen Formen, Materialien oder Lichtverhältnissen scheitern, die in den Daten nicht vorkamen.
- Langfristige mehrstufige Planung – Ketten aus mehr als einigen aufeinanderfolgenden Schritten sind nach wie vor schwieriger als einzelne Greif- oder Tragevorgänge.
- Sichere Autonomie ohne Aufsicht – die meisten aktuellen Industrieeinsätze, etwa Figure 03 im BMW-Werk in Spartanburg, laufen in einem beaufsichtigten Pilotbetrieb und nicht in voller betrieblicher Autonomie.
- Menge und Qualität der Trainingsdaten für einen bestimmten Roboterkörper (Embodiment) – Modelle wie GR00T oder GO-1 begegnen dem teilweise, indem sie Daten vieler Roboter zusammenführen, doch die Übertragung von Fähigkeiten zwischen unterschiedlichen mechanischen Konstruktionen bleibt ein aktives Forschungsfeld und kein gelöstes Problem.
Warum das bei der Wahl eines Roboters wichtig ist
Das VLA-Modell, mit dem ein Roboter arbeitet, bestimmt in der Praxis, wie flexibel er ohne teure Einzelprogrammierung für neue Aufgaben eingesetzt werden kann. Beim Vergleich von Modellen in der Kategorie humanoide Roboter lohnt es sich zu prüfen, ob der Hersteller überhaupt angibt, mit welchem KI-Modell der Roboter arbeitet (einem eigenen wie Helix oder einem auf einer Referenzplattform wie GR00T beruhenden), und ob er das mit einer konkreten Quelle belegt – und nicht nur mit dem Werbeschlagwort „künstliche Intelligenz“. Marktumfeld und Prognosen für die gesamte Kategorie der Humanoiden finden Sie in “Marktprognosen für humanoide Roboter”, und wie viele Freiheitsgrade ein solches Modell tatsächlich steuert, erklärt “Freiheitsgrade (DOF) bei humanoiden Robotern”.
Häufige Fragen
Was ist ein VLA-Modell (Vision-Language-Action)?
Ein KI-Modell, das Kamerabilder des Roboters und einen Befehl in natürlicher Sprache als Eingabe erhält und eine Folge konkreter Bewegungen (eine Aktionstrajektorie) ausgibt – anders als klassische Sprachmodelle, die nur Text erzeugen.
Ist ein VLA-Modell dasselbe wie ein in einen Roboter eingebautes ChatGPT?
Nein. Sprachmodelle (LLM) erzeugen Text und haben keinen direkten Zugriff auf die Motorsteuerung. VLA-Modelle werden gezielt mit Robotikdaten trainiert – Bewegungsaufzeichnungen, verknüpft mit Bildern und Befehlen –, und ihre Ausgabe sind konkrete Bewegungsparameter, keine Wörter.
Welche VLA-Modelle sind heute am weitesten entwickelt?
Auf dem kommerziellen Markt stechen NVIDIA Isaac GR00T (eine offene Referenzplattform), Figure Helix (ein proprietäres, von Figure AI selbst entwickeltes Modell) und Google DeepMind Gemini Robotics 2 (Partnerzugang / Warteliste) hervor. In Forschung und Open Source sind OpenVLA und das Modell GO-1 von AgiBot World am wichtigsten.
Was können VLA-Modelle 2026 noch nicht?
Die größten offenen Probleme sind: die Verallgemeinerung auf völlig neue, unvorhergesehene Situationen außerhalb der Trainingsdaten, die langfristige Planung mehrstufiger Aufgaben und der sichere Betrieb ohne menschliche Aufsicht in einer unstrukturierten Umgebung. Die Unternehmen selbst veröffentlichen selten harte Zahlen zur Erfolgsquote bei Aufgaben außerhalb kontrollierter Vorführungen.
Quellen
Links zu den Unterlagen, auf denen dieser Text beruht. Bevor Sie eine Entscheidung auf eine Zahl aus dem Artikel stützen, prüfen Sie sie an der Quelle.
Über die Autoren
Von Beruf leitender technischer Ingenieur einer Schiffsmaschinenanlage (Chief Engineer, mit Patent). Legt die redaktionellen Regeln der Seite fest und verantwortet sie; er liest nicht jede Unterseite vor der Veröffentlichung.
Die Texte erstellt die Redaktion mit KI-Werkzeugen. Wir vergleichen die Daten stichprobenartig mit Primärquellen, nicht Seite für Seite. Unsere Regeln stehen hier: Wie wir prüfen · Über uns